NTC Refrigeração
Plataforma IoT de monitoramento de refrigeração para redes de lojas: análise de performance, central de alarmes e app mobile, do escopo ao código
- Meu papel
- Designer UX/UI · Desenvolvedor Full Stack
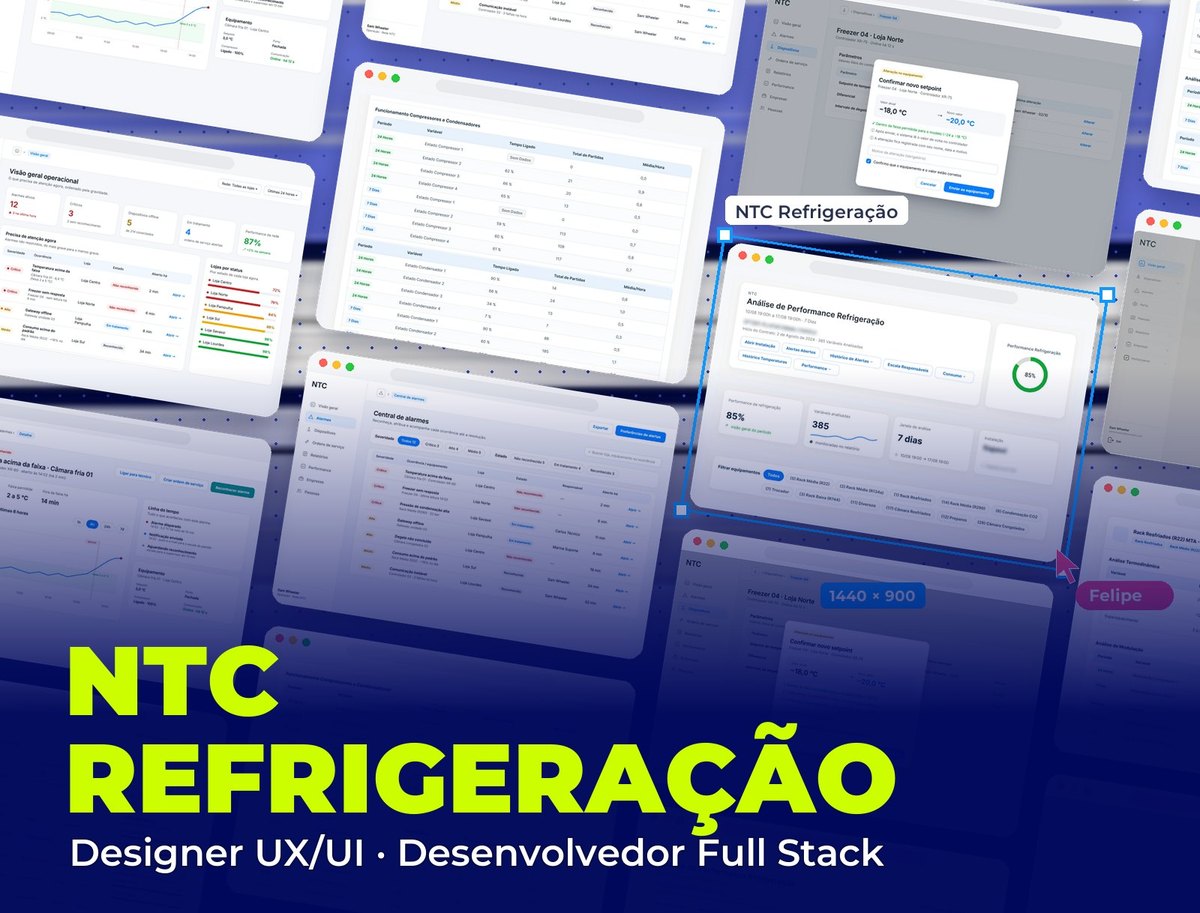 NTC Refrigeração
Contexto
A NTC Refrigeração instala e mantém sistemas de refrigeração em redes de lojas e supermercados. A plataforma centraliza os dispositivos conectados às lojas dos clientes para visualizar, analisar e ajustar os dados em tempo real. Fiz o UX/UI do produto inteiro e o desenvolvimento full stack.
Desafio
Um sistema de refrigeração gera centenas de variáveis por loja, e quem opera precisa saber em segundos o que está fora do normal. O desafio era transformar essa densidade em leitura rápida, sem esconder o detalhe técnico que o engenheiro precisa, e completar um escopo que não definia alarmes, permissões de escrita, perda de conexão, retenção de dados nem perfis de acesso por empresa.
Antes e depois
O ponto de partida foi uma declaração de escopo: uma lista de módulos e funcionalidades. O refinamento transformou essa lista num produto: a operação abre pelos alarmes, ordenados pela gravidade; alterar um parâmetro exige confirmação e fica registrado; cada perfil vê só as próprias lojas; e as decisões técnicas que ainda dependiam da equipe ficaram documentadas em vez de escondidas na tela.
A análise de performance
A tela mais densa do sistema, em alta fidelidade: um relatório por instalação que mostra primeiro o resultado e deixa o detalhe técnico logo abaixo, organizado por equipamento.
- 01 / 05
Resumo da instalação
O período, o contrato e as variáveis analisadas no topo, com a nota geral de performance num gráfico de anel e atalhos para alertas, histórico, escala de responsáveis e consumo. Logo abaixo, os indicadores do período e o filtro por grupo de equipamentos, com a contagem de cada um.
- 02 / 05
Equipamento por equipamento
Cada rack ganha um card com a própria nota de performance. A análise termodinâmica compara condensação, evaporação e superaquecimento com os limites, em 24 horas e 7 dias, com selos verde, âmbar e vermelho e a tendência. A análise de modulação mostra o quanto cada compressor trabalhou.
- 03 / 05
Compressores e condensadores
O funcionamento de cada estágio de compressor e condensador: tempo ligado, total de partidas e média por hora, que revelam desgaste e ciclos curtos antes de virarem falha.
- 04 / 05
Gerar análise
A análise é pedida num painel lateral: cliente, instalação e período, sem sair da tela em que a pessoa está.
- 05 / 05
Processamento
Enquanto o sistema correlaciona variáveis e indicadores, a tela mostra o esqueleto do relatório e uma barra de progresso, para a espera não parecer travamento.
As telas finais do MVP
As telas principais da operação em alta fidelidade, no mesmo sistema visual da análise de performance: cards brancos, azul para ação e cores de status só onde existe algo a resolver.
- 01 / 05
Visão geral operacional
A primeira tela responde "o que eu preciso resolver agora?": alarmes ativos, críticos, dispositivos offline, atendimentos em curso e a performance da rede, seguidos da lista de alarmes por gravidade e do ranking das lojas pelo pior estado.
- 02 / 05
Central de alarmes
Filtros por severidade e por estado com a contagem de cada um, e uma tabela que mostra de uma vez o equipamento, a loja, quem está tratando e há quanto tempo o alarme está aberto.
- 03 / 05
Detalhe do alarme
A temperatura atual contra a faixa permitida, o gráfico com a faixa desenhada ao fundo e o momento do alarme marcado, a linha do tempo do atendimento e as ações principais no topo: reconhecer, abrir ordem de serviço ou ligar para o técnico.
- 04 / 05
Alteração segura de parâmetro
O valor atual e o novo lado a lado, a confirmação de que está dentro da faixa do modelo, o motivo obrigatório e o aviso de que o valor será lido de volta no controlador.
- 05 / 05
Alerta no celular
A notificação já diz o equipamento, a loja e a temperatura. Ao abrir, o técnico vê o gráfico das últimas horas e pode reconhecer o alarme ou ligar para quem está de plantão.
Do escopo ao produto
Antes das telas, organizei o escopo num mapa do produto que a equipe pudesse validar, com as regras técnicas que ainda dependiam de decisão marcadas como pendentes.
- 01 / 03
Módulos e navegação
Os quatro módulos (administração, loja/web, app mobile e hardware) e o caminho que a pessoa faz: cliente/rede → loja → equipamento → telemetria → alarme → ação e histórico.
- 02 / 03
Central de alarmes como centro do MVP
A operação abre pelos problemas: alarmes ativos, alta severidade, dispositivos offline e em tratamento, e uma lista por severidade com loja, estado do atendimento e há quanto tempo está aberto.
- 03 / 03
Regras e decisões pendentes
Segurança de parâmetros, hardware e conectividade, dados e histórico, acessos por empresa e requisitos não funcionais, cada bloco com o que ainda precisava ser validado com engenharia e com os clientes.
Validação de fluxo em wireframe
O restante do MVP foi validado com a equipe em wireframes editáveis antes do visual final: cadastros, ordens de serviço, relatórios, preferências e acessos.
- 01 / 09
Dispositivos e conectividade
Cada controlador e gateway com status online ou offline e o tempo desde a última comunicação.
- 02 / 09
Loja e equipamentos
Dentro da loja, cada equipamento com o seu estado, para ir da rede ao freezer com problema em poucos cliques.
- 03 / 09
Relatórios e histórico
Temperatura e eventos por período, com a faixa permitida e os alarmes marcados na linha do tempo, e exportação em PDF.
- 04 / 09
Ocorrência e ordem de serviço
O alarme vira atendimento: prioridade, técnico responsável e o registro do diagnóstico e das ações realizadas.
- 05 / 09
Cadastro de dispositivo
Nome, identificador, loja, modelo do controlador e protocolo de conexão, ligando o equipamento físico ao sistema.
- 06 / 09
Exportação de relatório
Tipo de relatório, escopo (rede, loja ou equipamento), período, formato CSV ou PDF e resolução dos dados.
- 07 / 09
Preferências de alertas
Os canais de cada pessoa (push, e-mail, WhatsApp/SMS) e os destinatários por severidade.
- 08 / 09
Usuários e permissões
A equipe com perfil, unidade, último acesso e status, e o convite por e-mail para o usuário criar a própria senha.
- 09 / 09
Login
A entrada da plataforma com e-mail corporativo e o pedido de acesso, que pode depender de aprovação.
App mobile
12 telas para quem está na rua ou na loja: receber o alerta, ver o gráfico, reconhecer o alarme, confirmar um parâmetro, acompanhar ordens de serviço e notificações.
Fluxos de navegação
Cinco fluxos para o protótipo clicável: alarmes, equipamentos, atendimento, acessos e administração/relatórios.
Arquitetura
Uma stack pensada para telemetria: muitos dados chegando o tempo todo, alertas que não podem atrasar e o mesmo back-end servindo a web e o app.
Regras que o produto garante
Num sistema que mexe em equipamento real, algumas regras não podem depender só da interface:
Sistema Visual
Um visual técnico e claro: fundo cinza-claro, cards brancos, azul para ação e as cores de status reservadas para o que importa (verde dentro da faixa, âmbar em atenção, vermelho crítico), para que a pessoa ache o problema só pela cor.
Paleta
Azul Ação
#087CFF
Botões, filtros ativos e links
Verde Performance
#13A63B
Dentro da faixa e nota de performance
Âmbar Atenção
#A77600
Fora do ideal, sem ser crítico
Vermelho Crítico
#C7292E
Alarmes críticos e falhas
Verde-azulado
#0D9488
Ações de atendimento e confirmação
Grafite
#1F2B36
Títulos e textos
Tipografia
Inter
400 / 500 / 600 / 700
Fonte única: títulos, tabelas e números
Aprendizado
Em sistemas densos, o trabalho de UX é decidir a ordem da leitura: primeiro o resultado, depois o motivo, por último o dado bruto. Documentar o escopo como produto, com as decisões pendentes à vista, evitou desenhar telas em cima de regras que ninguém tinha validado.
Outros projetos para conhecer.
 Cidadania & Imigração
Vogel Cidadania Italiana
Landing page de captação para assessoria de cidadania italiana, do UX/UI ao código em React, com formulário de avaliação gratuita, API de leads e versão mobile
Ver projeto SaaS · Gestão de Estoque
Mimos Papelaria
Sistema SaaS de gestão de estoque para papelaria: produtos, movimentações, categorias, fornecedores e relatórios, com UI/UX, front-end em React e back-end
Ver projeto Saúde · TypeScript e Node.js
Clinvia
Plataforma para redes de clínicas em TypeScript e Node.js: agenda, agendamento online, prontuário, convênios do pedido de autorização ao faturamento e app do paciente
Ver projeto